RAG 검색증강
문서를 잘게 쪼개 벡터 공간에 흩뿌리고, 질문과 비슷한 조각을 긁어옵니다. 매뉴얼 검색에는 좋지만 "A 가 B 의 원인이다" 같은 관계는 흩어집니다. 여러 단계를 건너야 하는 질문 앞에서 조각을 섞다 환각에 빠집니다. 매 질문마다 처음부터 다시 읽습니다.
왜 만들었나
문서를 잘게 쪼개 벡터 공간에 흩뿌리고, 질문과 비슷한 조각을 긁어옵니다. 매뉴얼 검색에는 좋지만 "A 가 B 의 원인이다" 같은 관계는 흩어집니다. 여러 단계를 건너야 하는 질문 앞에서 조각을 섞다 환각에 빠집니다. 매 질문마다 처음부터 다시 읽습니다.
데이터를 객체·관계·속성의 지식 그래프로 세우고, 그 위에서 에이전트가 판단 → 예상 → 예측 → 실행합니다. 다단계 질문은 그래프 쿼리 한 줄이 0.1초에 답합니다. 학습한 것은 누적됩니다. 뉴럴(LLM)과 심볼릭(온톨로지)의 결합입니다.
어떻게 동작하나
내려가면서 왼쪽 그래프가 각 걸음의 모습으로 바뀝니다.
메일·DB·API·MCP — 흩어진 데이터 소스를 파이프라인으로 받습니다. 무가치한 것은 이 문턱에서 걸러집니다.
원본에 없던 것을 채웁니다. 서명에서 이름·회사·연락처를 읽어 붙이는 식으로 — 낮은 밀도의 데이터가 고밀도 지식이 됩니다.
미리 정의한 기준으로 가릅니다. 스키마가 요구하는 필수·고유·형식 검증이 여기서 걸립니다.
공통성을 찾아 객체·관계·속성으로 엮습니다. 이때부터 데이터는 표가 아니라 그래프입니다.
액션 노드가 움직입니다. Input → Process → Output. 결과는 다시 온톨로지에 기록되어 다음 판단의 근거가 됩니다.
인과를 따라 특이점을 찾고, 시뮬레이션하고, 결정합니다. 검색이 아니라 판단 — RAG 가 아니라 DAG 입니다.
지식 관리 3층
시계열로 프로세스 변화를 읽고, 가상 시뮬레이션을 돌려 특이점을 찾습니다. "중복 자원을 없애려면 역할을 이렇게 나누라" 같은 개선안이 여기서 나옵니다.
twin_id 로 현실과 1:1 로 묶인 디지털트윈. Input → Process → Output 의 액션 노드가 움직이고, 결과는 온톨로지 상태에 재귀적으로 기록됩니다.
메일·DB·API 에서 들어온 것을 객체·관계·속성으로 구조화하고, 부족한 것은 강화 파이프라인이 채웁니다. 필수·고유·형식 검증이 입구에서 걸립니다.
실제 화면
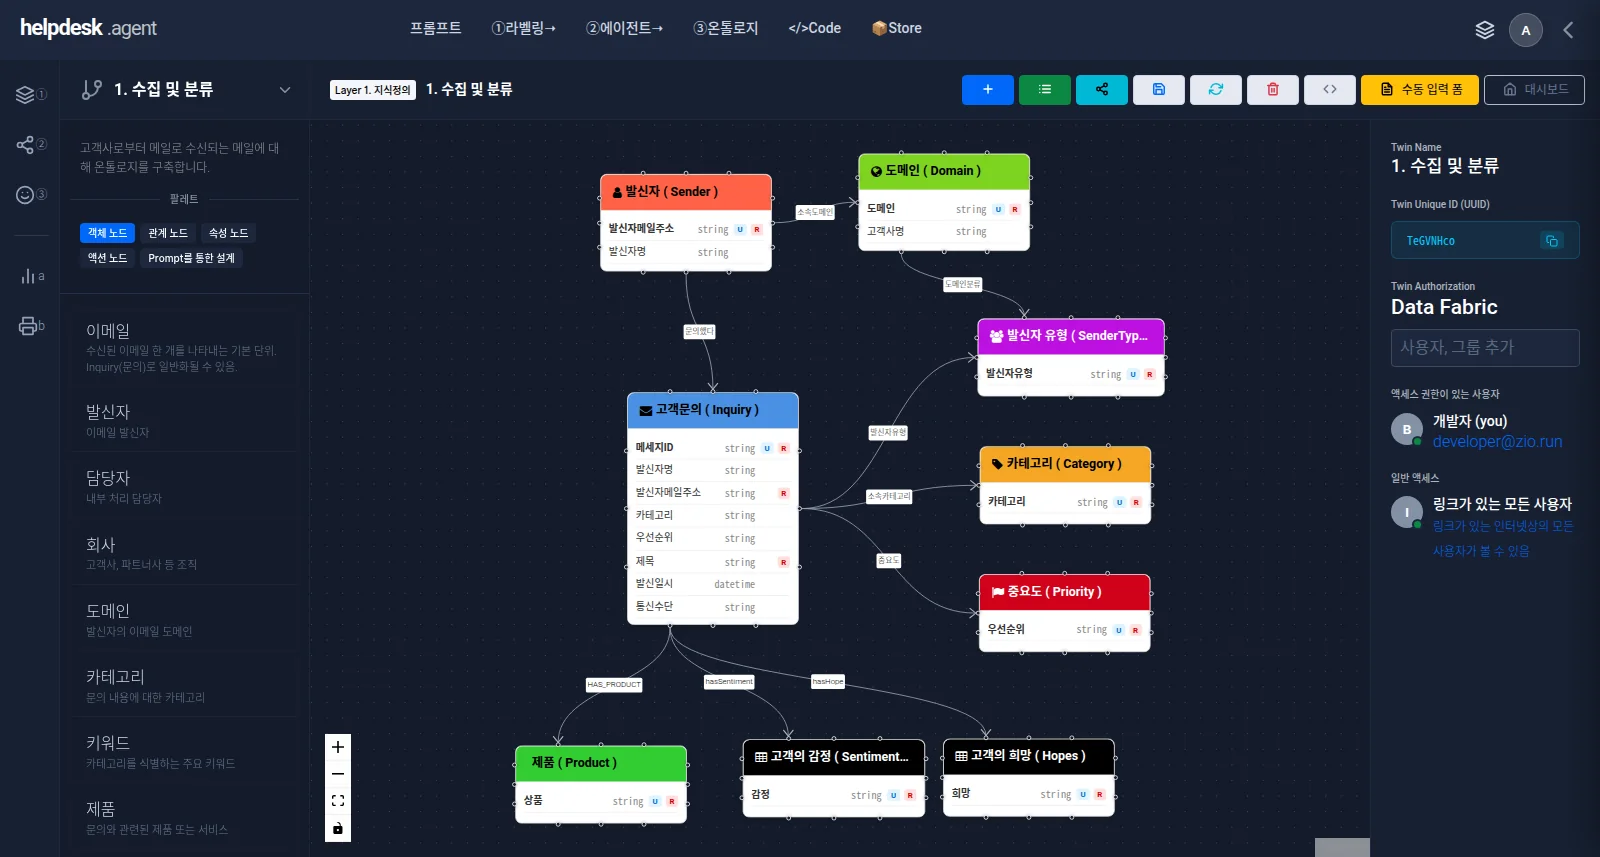
객체·관계·속성·액션 노드를 그려 온톨로지를 정의합니다. 필수·고유·관계 수량(1:n)까지 여기서 정해져 에이전트가 컴파일될 때 검증됩니다.
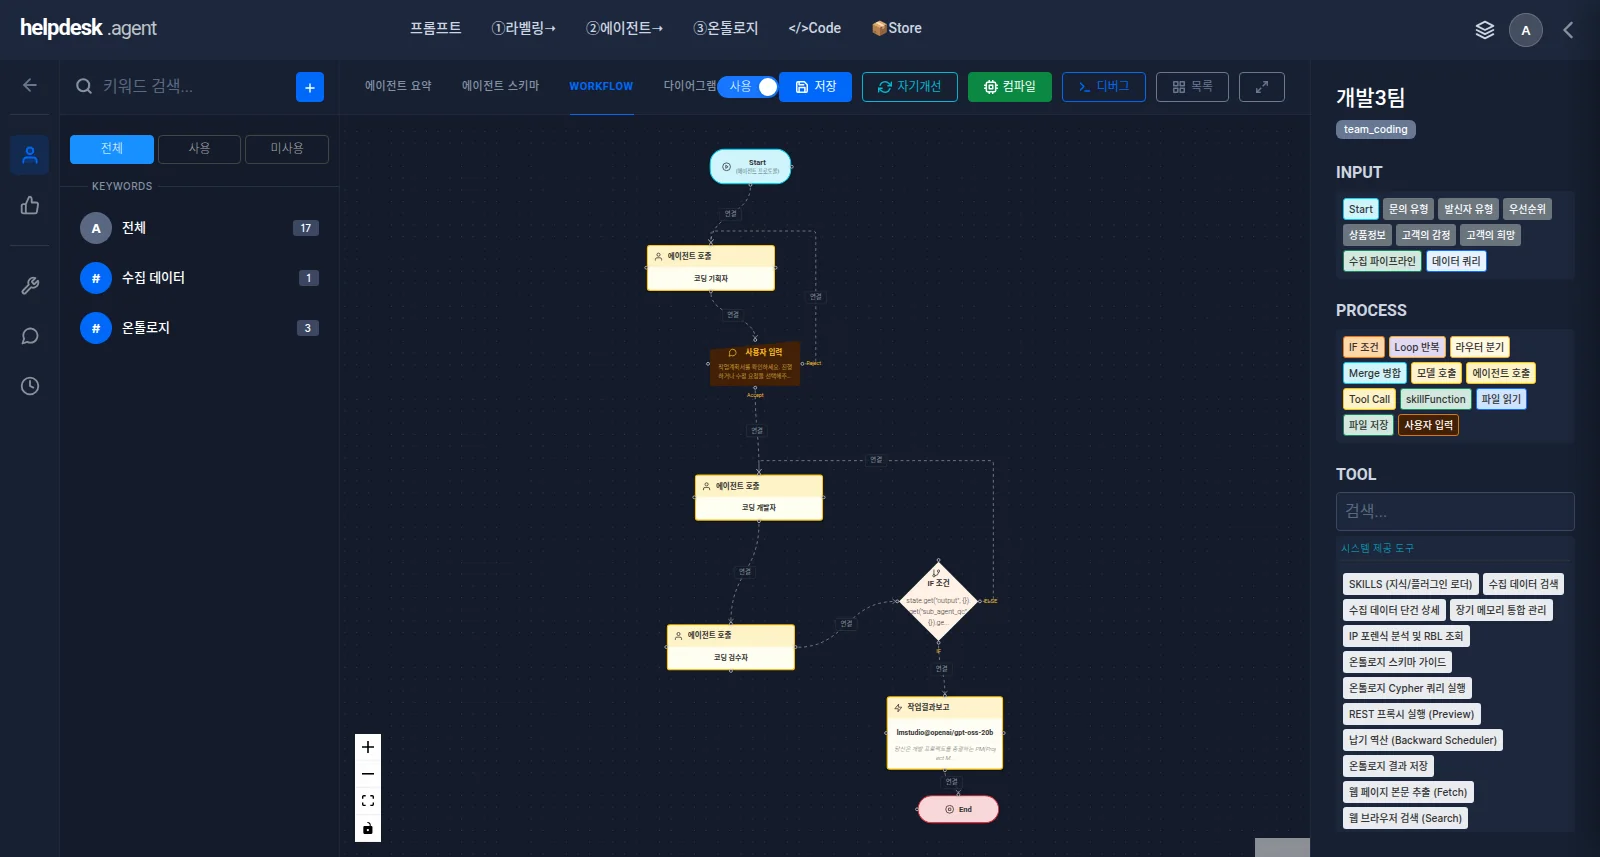
시작·조건·반복·병합·모델 호출·에이전트 호출·스킬 — 노드를 잇고 컴파일하면 LangGraph 코드가 됩니다. 디버그는 한 노드씩.
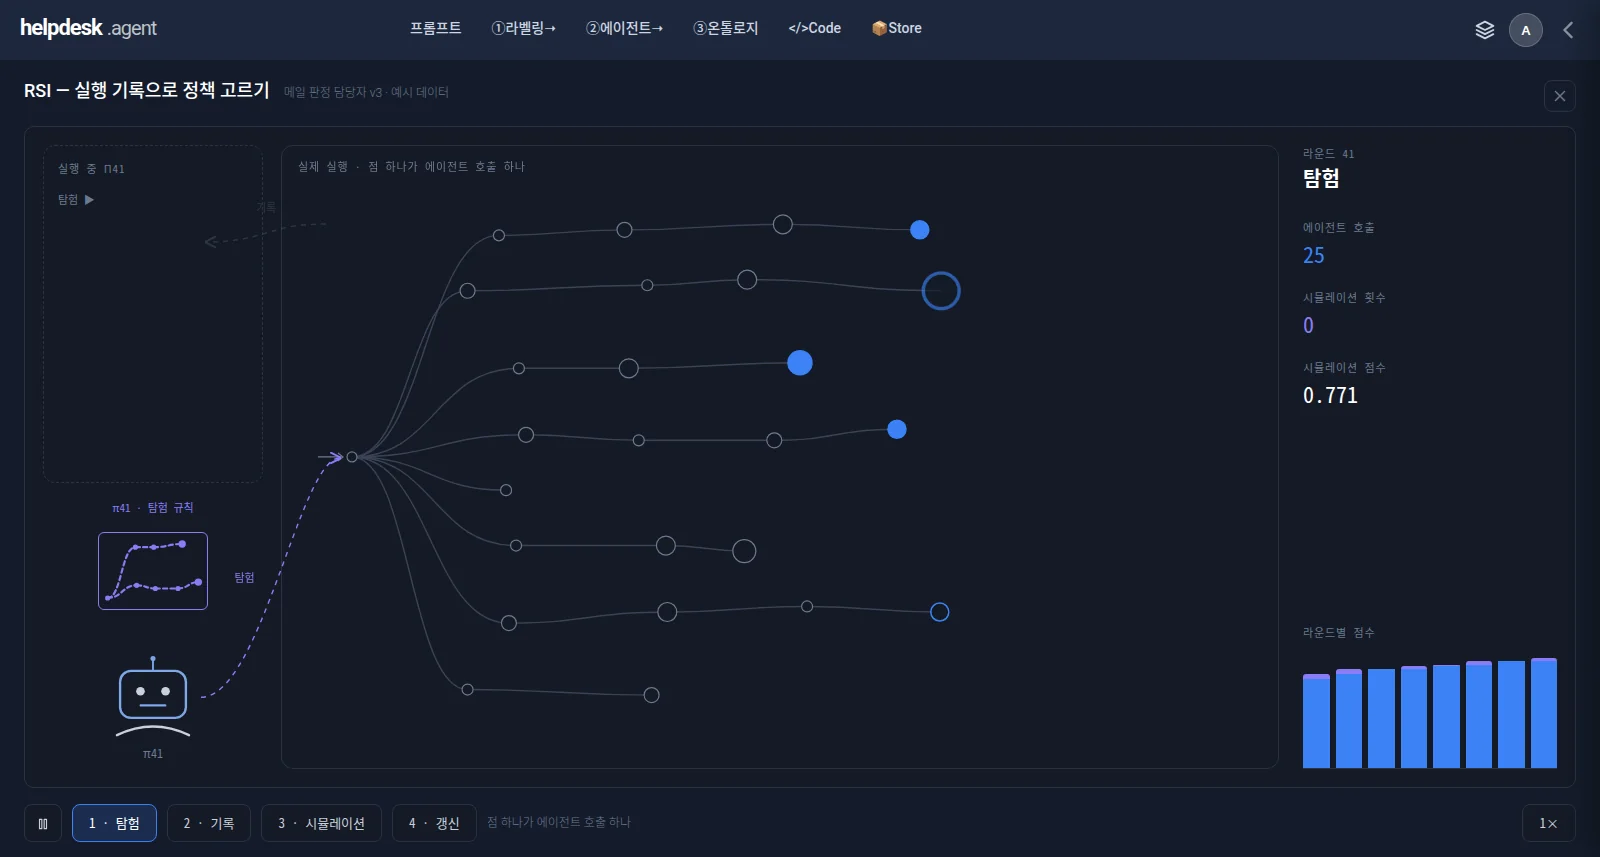
실행 기록을 남기고, 시뮬레이션으로 정책을 비교하고, 더 나은 정책으로 갱신합니다. 탐험 → 기록 → 시뮬레이션 → 갱신.
쓰이고 있는 곳
수주가 들어오면 BOM 을 그래프로 재귀 전개하고, 설비 가동률·휴일·납기를 역산해 일자별 생산계획을 만듭니다. 원시 텍스트 방식과 비교해 온톨로지 방식이 정밀 추출·재귀 탐색·재활용 전부에서 앞섰습니다.
SMTP 로 신고 메일을 받아 분류·온톨로지화하고, 첨부는 격리된 CDR 워커(ClamAV·YARA·OCR)가 무해화해 상세 로그와 함께 돌려줍니다. 인메모리 퍼지 해싱으로 다형성 유출 메일을 세션 단계에서 끊는 방식은 특허 출원 중입니다.
같은 고객이 몇 시간 간격으로 두 번 보낸 결함 메일을, 담당자가 달라도 하나의 사건으로 묶었습니다. 발신자·도메인·카테고리·중요도가 관계로 연결돼 있기 때문입니다.
기술
장비 한 대(DGX Spark, 128GB 통합 메모리)에 LLM 서빙 하나와 인스턴스 열둘. 인스턴스는 컨테이너 12개짜리 독립된 세계이고, 고객마다 자기 온톨로지·자기 에이전트·자기 SSH 작업 자리를 갖습니다. 모델은 로컬(CUDA · ROCm)에서 돕니다.